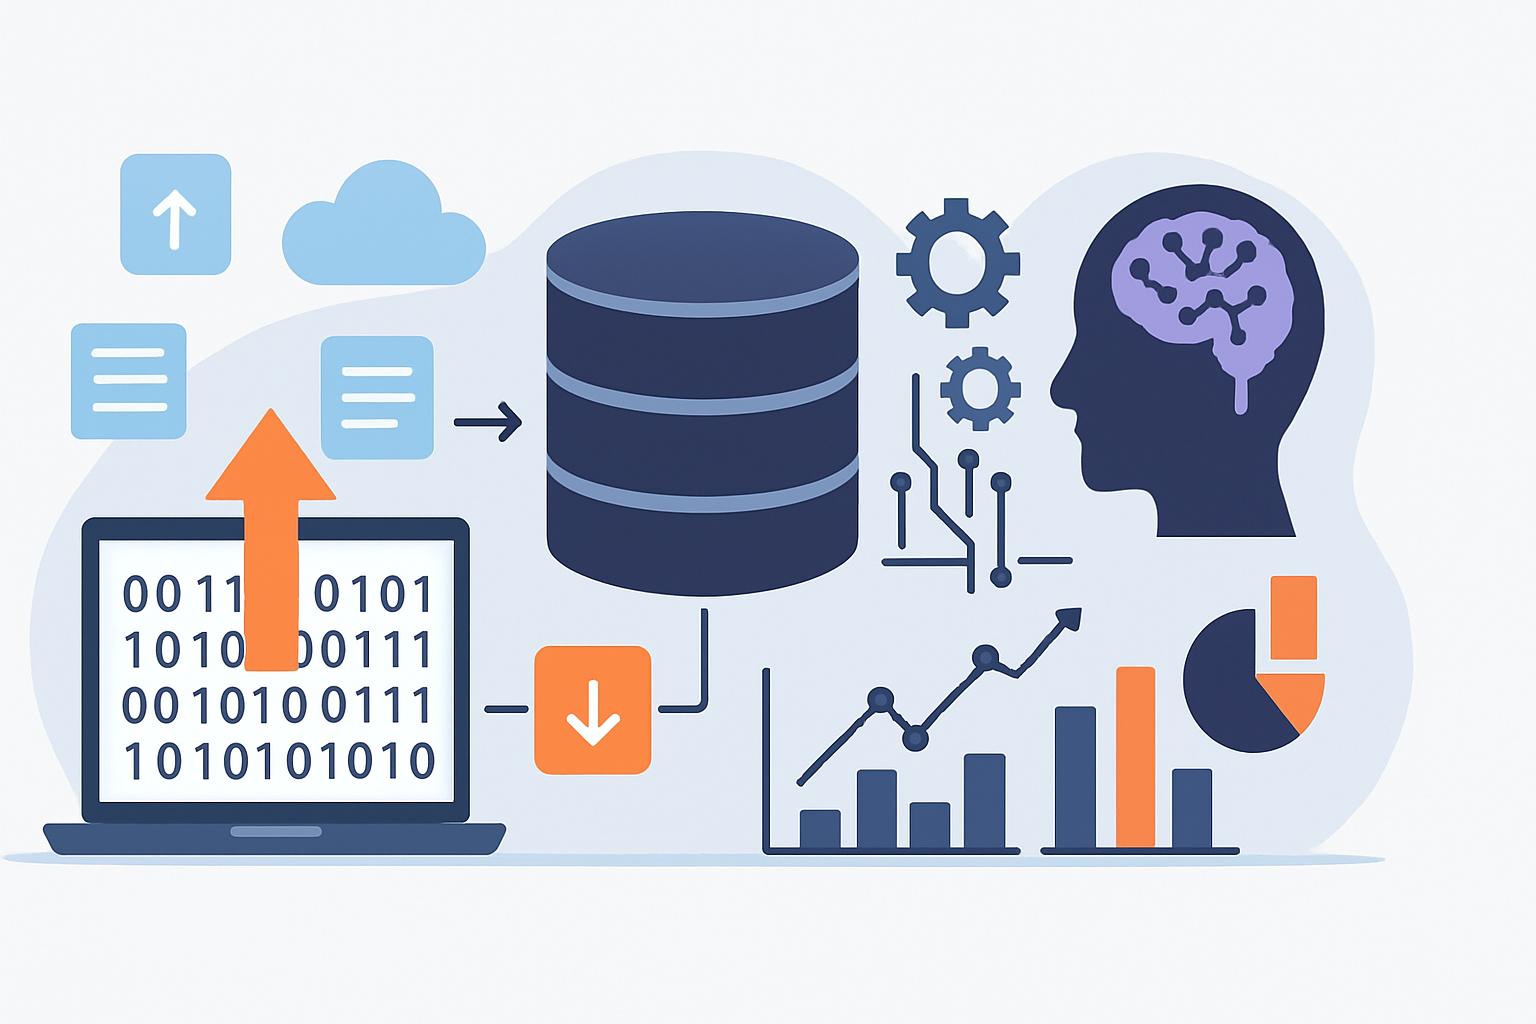
Современные аналитические инструменты для больших данных: загрузка, хранение, обработка, аналитика и машинное обучение — это набор технологий и методик, которые позволяют собирать огромные объёмы информации, сохранять её в масштабируемых системах, обрабатывать в реальном времени или пакетно, извлекать инсайты с помощью аналитики и строить модели машинного обучения для прогнозов и автоматизации решений.
Преимущества таких инструментов очевидны: **ускорение принятия решений**, **повышение качества прогнозов**, **снижение затрат на обработку данных** и **возможность работать с потоками в реальном времени**. Особенности включают распределённость, отказоустойчивость, оптимизацию хранения и гибкость в выборе стека для задач загрузки, хранения, обработки, аналитики и машинного обучения.
1. Архитектурные основы: какие компоненты входят в стек
1.1. Компоненты и их роли
Типичный стек для работы с большими данными разделяется на уровни: сбор и загрузка данных, хранение, обработка, аналитика и применение моделей машинного обучения. Каждый уровень выполняет специфическую роль и должен быть оптимизирован под характер нагрузки.
Загрузка отвечает за интеграцию источников, хранение — за долговременное и оперативное хранение, обработка — за трансформации данных, аналитика — за визуализацию и отчётность, а машинное обучение — за построение и развёртывание моделей.
1.2. Краткая расшифровка аббревиатур
В этой области часто встречаются аббревиатуры. ETL (Extract, Transform, Load) — извлечение, преобразование, загрузка. ELT (Extract, Load, Transform) — извлечение, загрузка, преобразование. OLAP — Online Analytical Processing, операционная аналитическая обработка. OLTP — Online Transaction Processing, операционная обработка транзакций. API — Application Programming Interface, интерфейс прикладного программирования. ML — машинное обучение.
Эти термины помогают сориентироваться при выборе инструментов для загрузки, хранения, обработки, аналитики и машинного обучения.
1.3. Принципы проектирования архитектуры
Планируя систему, важно руководствоваться принципами модульности, наблюдаемости и масштабируемости. Архитектура должна позволять заменять компоненты без полного рефакторинга, обеспечивать метрики и логи, а также горизонтальное масштабирование при росте объёмов данных.
**Нельзя жертвовать качеством данных ради скорости доставки**; грамотный баланс между загрузкой и последующей обработкой критичен для итоговой аналитики и работы моделей.
2. Загрузка данных: инструменты и паттерны
2.1. Типы загрузки: пакетная и потоковая
Загрузка данных бывает пакетной (batch) и потоковой (streaming). Пакетная загрузка хорошо подходит для больших, периодически пополняемых наборов; потоковая — когда нужны события в режиме реального времени.
Выбор способа влияет на последующие слои: хранение для потоковых данных требует низкой задержки, обработка — поддерживает стриминг-обработчики, а аналитика — интерактивные дашборды.
2.2. Инструменты для интеграции и ETL/ELT
На рынке доступны разнообразные инструменты для загрузки и интеграции: Apache NiFi, Apache Kafka, Logstash, Fluentd, Talend, Fivetran и собственные коннекторы облачных платформ. Они покрывают разные сценарии — от простых копирований до сложных преобразований в потоке.
ETL-подход остаётся востребованным для трансформации до загрузки, а ELT популярен там, где хранилище справляется с преобразованиями на своей стороне — например, в облачных дата-скервах.
2.3. Настройки качества и проверка данных при загрузке
Контроль качества при загрузке включает валидацию схем, дедупликацию, разбор ошибок и обогащение метаданными. Часто на этапе загрузки фиксируются метрики полноты, точности и временной свежести.
**Лучше отлавливать критические ошибки как можно раньше**, чтобы не загрязнять систему хранением плохих данных, что усложнит обработку и обучение моделей.
- Паттерны загрузки: snapshot, incremental, CDC (Change Data Capture).
- Инструменты: Kafka Connect, Debezium для CDC, Sqoop для миграции из реляционных баз.
- Метрики загрузки: throughput, latency, error rate.
3. Хранение больших данных: где и как держать информацию
3.1. Типы систем хранения
Для хранения используют файловые слои (HDFS, S3), колоночные хранилища (Apache Parquet, ORC), реляционные хранилища, NoSQL-решения (Cassandra, MongoDB) и специализированные дата-лейкхаусы/датамарт-платформы.
Выбор зависит от сценариев: аналитические запросы выигрывают от колоночных форматов, OLTP — от реляционных баз, а быстро изменяющиеся структуры лучше хранить в NoSQL.
3.2. Сравнение хранения: долговременное vs оперативное
Долговременное хранение ориентировано на экономию и долговечность, оперативное — на низкие задержки и быстрый доступ. Часто используют гибридные стратегии с горячими и холодными слоями.
**Холодный слой** экономит бюджет и подходит для архивов, **горячий слой** обеспечивает быстрые отклики аналитики и моделей.
3.3. Метаданные и каталогизация
Каталогизация данных — обязательный элемент. Системы типа Apache Hive Metastore, AWS Glue или Amundsen помогают отслеживать схемы, владельцев и качество данных.
Без метаданных аналитика и машинное обучение превращаются в угадывание структуры; поэтому каталоги стоит строить с самого начала проекта.
| Тип хранения | Подходит для | Преимущества | Ограничения |
|---|---|---|---|
| Объектное хранилище (S3, HDFS) | Архивы, data lake | Дешево, масштабируемо | Высокая задержка при мелких файлах |
| Колоночное (Parquet, ORC) | Аналитические запросы | Эффективное сжатие, быстрые агрегации | Менее удобно для обновлений |
| NoSQL (Cassandra, MongoDB) | Гибкие схемы, быстрый доступ | Высокая доступность, масштабирование | Ограниченная функциональность SQL |
4. Обработка данных: движки, паттерны и оптимизация
4.1. Движки обработки: batch и stream
Для пакетной обработки используют Apache Spark, Apache Flink в пакетном режиме, MapReduce исторически. Для стриминга популярны Apache Flink, Apache Kafka Streams и Spark Structured Streaming.
Реальные системы комбинируют оба подхода: поток для оперативных задач и пакет для сквозных перерасчётов и исторических анализов.
4.2. Оркестрация рабочих процессов
Оркестрация нужна, чтобы управлять зависимостями, ретраями и мониторингом. Инструменты: Apache Airflow, Luigi, Prefect, Argo Workflows. Они контролируют как загрузку данных, так и трансформации и обучение моделей.
**Оркестрация повышает устойчивость процессов** и упрощает отладку публичных конвейеров данных.
4.3. Оптимизация и распределённая обработка
Оптимизация включает партиционирование данных, правильный формат файлов, кеширование, настройку ресурсов и тюнинг запросов. Распараллеливание и распределённое хранение позволяют обрабатывать петабайты, но требуют грамотного управления ресурсами.
Современные платформы предлагают встроенные оптимизации: adaptive query execution, data skipping, vectorized processing — они снижают накладные расходы и ускоряют обработку.
- Шаблоны обработки: ELT, Lambda (смешанный), Kappa (стриминг-сфокусированный).
- Лучшие практики: минимизировать мелкие файлы, использовать колоночные форматы, применять партиционирование по времени.
- Метрики: время выполнения, коэффициент перераспределения данных (shuffle), ресурсоёмкость.
5. Аналитика и визуализация: как извлекать ценность
5.1. BI-инструменты и отчётность
Для визуализации и дашбордов применяют Power BI, Tableau, Looker, Metabase. Они подключаются к хранилищам и позволяют строить отчёты, которые переводят данные в понятные бизнес-метрики.
**Важно формировать KPI совместно с бизнесом**, иначе дашборды превратятся в набор красивых графиков без практической пользы.
5.2. Аналитика на больших объёмах
Аналитика больших данных требует аналитических баз или data warehouses, оптимизированных под сложные запросы. Решения типа Snowflake, Google BigQuery, Amazon Redshift применяются для интерактивных аналитических нагрузок.
Параллельные запросы и распределённые индексы помогают поддерживать интерактивность даже при больших объёмах.
5.3. Self-service аналитика и данные для бизнеса
Self-service подход даёт аналитикам и продуктовым командам возможность самостоятельно исследовать данные. Для этого нужны каталог данных, управляемые представления и шаблоны запросов.
**Самообслуживание не отменяет централизации стандартов**; нужна дисциплина в метриках, схемах и доступах.
| Инструмент | Сценарии | Особенности |
|---|---|---|
| Tableau | Дашборды, визуализация | Гибкий интерфейс, богатая визуализация |
| Looker | Бизнес-аналитика | Модельный слой, централизованные метрики |
| BigQuery | Аналитика на больших объёмах | Serverless, масштабируемый SQL |
6. Машинное обучение: от данных к моделям
6.1. Подготовка данных для обучения
Подготовка включает очистку, преобразование, создание признаков и разбиение на обучающую и тестовую выборки. Качественная инженерия признаков часто даёт больший выигрыш, чем подбор модели.
Используются фреймворки для обработки признаков и конвейеров: feature stores, такие как Feast, помогают централизовать и переиспользовать признаки в онлайн и офлайн режимах.
6.2. Инструменты ML и платформы MLOps
Для экспериментов и развёртывания применяют TensorFlow, PyTorch, scikit-learn, а для MLOps — MLflow, Kubeflow, TFX (TensorFlow Extended). Эти инструменты помогают версионировать модели, отслеживать эксперименты и автоматизировать развертывание.
**MLOps уменьшает разрыв между разработкой модели и её эксплуатацией**, что критично для стабильной работы моделей на продакшене.
6.3. Развёртывание и мониторинг моделей
Модели разворачивают как REST/gRPC-сервисы, встраивают в стриминг- конвейеры или запускают пакетно. Мониторинг метрик предсказаний, дрейфа данных и качества помогает выявлять деградацию моделей вовремя.
Важно иметь систему отката и возможность быстрой переобучки на обновлённых данных, чтобы не допустить длительной потери качества решений.
Опыт показывает: модель, идеально обученная на исторических данных, часто теряет эффективность без постоянного мониторинга и обновления.
- Фреймворки ML: TensorFlow, PyTorch, scikit-learn.
- MLOps-инструменты: MLflow, Kubeflow, TFX, DVC (Data Version Control).
- Метрики для моделей: AUC, precision/recall, RMSE, drift-score.
7. Управление данными, безопасность и соответствие
7.1. Управление доступом и защита данных
Контроль доступа реализуют через RBAC (role-based access control), шифрование в покое и при передаче, а также через токенизацию чувствительных полей. Правильная политика доступов снижает риск утечек и правонарушений.
**Грамотная сегрегация прав доступа** предотвращает случайное использование критичных данных в исследованиях и повышает доверие к системе.
7.2. Соответствие требованиям и аудит
Для компаний важно соответствовать отраслевым и государственным требованиям: GDPR (General Data Protection Regulation — Общий регламент защиты данных), HIPAA для здравоохранения и локальным законам о персональных данных. Необходимо вести аудит доступа и действий с данными.
Автоматизированные отчёты и сохранение журналов позволяют быстро проверить выполнение требований и подготовить доказательства для аудита.
7.3. Качество данных и governance
Data governance включает правила именования, стандарты форматов, процессы для режима исправления ошибок и SLA на качество данных. Инструменты контроля качества, такие как Great Expectations или Deequ, помогают формализовать проверки.
**Без governance любая попытка аналитики и машинного обучения обречена на неэффективность**, потому что метрики и определения будут расходиться между командами.
- Шаг 1: определить владельцев данных и уровни ответственности.
- Шаг 2: настроить метрики качества и правила проверки на этапе загрузки.
- Шаг 3: автоматизировать оповещения и процесс исправления ошибок.
8. Практическое внедрение: кейсы и рекомендации
8.1. Примерного плана миграции на современный стек
Миграция начинается с оценки текущих процессов, выбора пилотного проекта и постройки минимального конвейера end-to-end: загрузка, хранение, обработка, аналитика и машинное обучение. Пилот помогает определить узкие места и разработать шаблоны для масштабирования.
Дальше следует поэтапный перенос рабочих нагрузок, автоматизация оркестрации и внедрение мониторинга качества данных и моделей.
8.2. Примеры из практики автора
В одном проекте я помогал переносить аналитическую платформу на облачный data lake. Мы выделили пилот по мониторингу клиентских транзакций, реализовали потоковую загрузку через Kafka, сохранили данные в S3 в формате Parquet и настроили Spark для пакетной обработки.
Через полгода оперативная аналитика стала доступна в режиме близком к реальному времени, а модели прогнозирования отказов показали снижение ложных срабатываний на 30 процентов. Этот опыт подтвердил, что баланс между загрузкой, хранением и обработкой — ключ к успешной аналитике и машинному обучению.
8.3. Рекомендации по выбору инструментов
При выборе следует ориентироваться на конкретные требования: задержки, объёмы, бюджет, компетенции команды. Универсального стека не существует, но разумный минимум включает инструмент для потоковой загрузки, хранилище с колоночным форматом, движок обработки и платформу для экспериментов с ML.
**Ставьте на совместимость и открытые стандарты**, это облегчит замену компонентов в будущем и снизит зависимость от одного поставщика.
- Не переусложняйте архитектуру на старте — начинайте с малого.
- Инвестируйте в метаданные и каталоги с самого начала.
- Устанавливайте SLA на качество данных и реакции на инциденты.
- Выделяйте ресурсы на мониторинг моделей в продакшене.
- Обучайте команды работать с выбранным стеком: аналитика, обработка, ML.
- Планируйте резервные сценарии и тесты отказоустойчивости.
9. Тенденции и куда движутся технологии
9.1. Облачные сервисы и serverless
Переход в облако продолжает ускоряться; serverless-подход снижает операционные расходы и упрощает масштабирование. Платформы предлагают готовые сервисы для загрузки, хранения, обработки, аналитики и машинного обучения, что сокращает время от идеи до продукта.
**Однако облако не решает проблем с качеством данных и управлением** — эти задачи остаются за командой.
9.2. Единство данных: data mesh и федерация
Data mesh предлагает децентрализованную модель владения данными, где команды отвечают за свои доменные наборы и предоставляют их как продукт. Это меняет подходы к хранению, обработке и аналитике, делая их более доменно-ориентированными.
Федерация данных помогает объединять источники без полной централизации, что полезно при распределённых организациях.
9.3. Автоматизация и AutoML
AutoML инструменты упрощают подбор моделей и гиперпараметров, но не заменяют экспертизу в подготовке данных и интерпретации результатов. Автоматизация разворачивания и мониторинга моделей остаётся ключом к масштабируемому ML в продакшене.
**Автоматизация дает скорость, но не качество сама по себе**; она эффективна в руках опытной команды.
| Тренд | Влияние на стек | Что важно для команды |
|---|---|---|
| Облачный serverless | Упрощение масштабирования, снижение ОС | Контроль затрат, безопасность |
| Data mesh | Децентрализация владения данными | Стандарты, каталоги, контракты данных |
| AutoML и MLOps | Быстрее валидация идей | Качество данных, мониторинг |
Современные аналитические инструменты для больших данных: загрузка, хранение, обработка, аналитика и машинное обучение объединяют технологии, процессы и практики. Они позволяют переводить необработанные события в бизнес-решения и интеллектуальные сервисы.
Если вы начинаете или реорганизуете платформу, начните с чёткого определения целей, выберите пилотный сценарий и постройте сквозной конвейер. Это даст реальную проверку гипотез и базу для масштабирования в сторону более зрелой архитектуры данных.